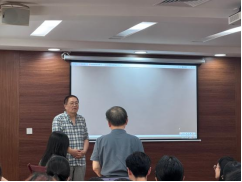
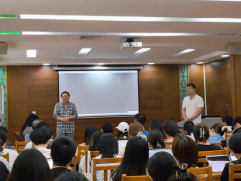
2026年9月28日下午,清华大学人文学院江铭虎教授应我中心邀请,在白云山校区第八教学楼306室作题为“大脑、语言与大模型:从生物语言能力到人工语言计算”的学术讲座。讲座前,中心副主任徐海教授向江铭虎教授及在场师生介绍了中心的建设与研究情况。我校百余名研究生到场聆听,现场座无虚席。我中心的王初明教授、杜家利教授等专家学者也出席了学术讲座。
江铭虎教授从语言与大脑的演化关系谈起,介绍了人类发音器官、大脑结构与语言能力的发展。他结合动物交流的例子指出:人类能够对外部事物进行抽象命名,也能够将已有的语言单位重新组合,表达新的意思。在讨论大脑的语言加工时,他还介绍了人类脑区连接与功能偏侧化的特点,以此说明语言能力与大脑演化之间的密切联系。

讲 座 现 场 图 片
围绕语言本身的结构与使用规律,江铭虎教授进一步讲解了人类语言如何由较小的单位构成词语、短语和句子,并形成层级化的表达。他以词汇使用频率与长度的关系为例,介绍了语言使用中的规律,讨论人们如何以较低的交流成本传递信息。这些现象为我们理解机器如何表示和处理语言提供了切入点。
在人类语言转向人工智能的讨论时,江铭虎教授回顾了神经网络与自然语言处理的发展。他结合神经元连接和视觉信息分层加工等研究,介绍了神经科学对早期人工神经网络的启发。此外,他还以词嵌入为例,说明计算机如何将词语表示为可计算的向量,并利用向量之间的关系处理语义信息。谈到Transformer时,江教授介绍了注意力机制在处理上下文信息中的作用,以及这一架构对大模型发展的影响。
在讨论不同语言模型处理文本的方式时,江教授指出:有的模型可以利用上下文推测被遮蔽的词,这种方法主要用于语言理解。有的模型可以依据已有内容预测后续文本,这种处理主要用于语言生成。他还梳理了从数据清洗、预训练到针对具体任务进行微调的过程,强调了语料质量对模型表现的重要性。这些讲解使大模型的训练与运行过程变得更加具体。
谈及实际应用,江铭虎教授以机器翻译和文本摘要为例,介绍了大模型利用上下文信息完成语言任务的方式。与此同时,他也指出,模型生成的内容可能存在事实错误、知识偏差或推理矛盾。使用大模型辅助学习与研究时,学习者仍需根据任务要求检查其输出,尤其要核对关键事实和论证过程。

讲 座 现 场 图 片
在交流环节,王初明教授结合“续论”研究,就续写、互动与大语言模型之间的关系提出问题。江铭虎教授作出回应,双方围绕语言生成、人机对话及大模型在外语学习中的应用展开讨论。一位中心的博士生就认知语义与隐喻研究中的计算方法提问。江铭虎教授结合具体研究情境,谈到从语言实例出发应选择好分析方法并综合使用不同模型。他提醒研究者要关注实验方法的适用范围。
此次讲座从人类语言的形成与使用谈到大模型的技术发展和实际应用,为师生理解语言学、脑科学与人工智能之间的联系提供了跨学科视角。


热 烈 讨 论