2026年11月12日下午,来自雅典大学的海外名师Christina Alexandris教授应我中心邀请,作了题为“Gen-AI and Socially Responsible AI in Natural Language Processing Applications: A Linguistic Perspective”(自然语言处理应用中的生成式人工智能与社会责任:语言学视角)的学术讲座。讲座由中心的杜家利教授主持。我校外国语言学及应用语言学专业博士生、国际中文教育专业硕士生等到场聆听。秦丽莉教授等专家学者也出席了讲座。
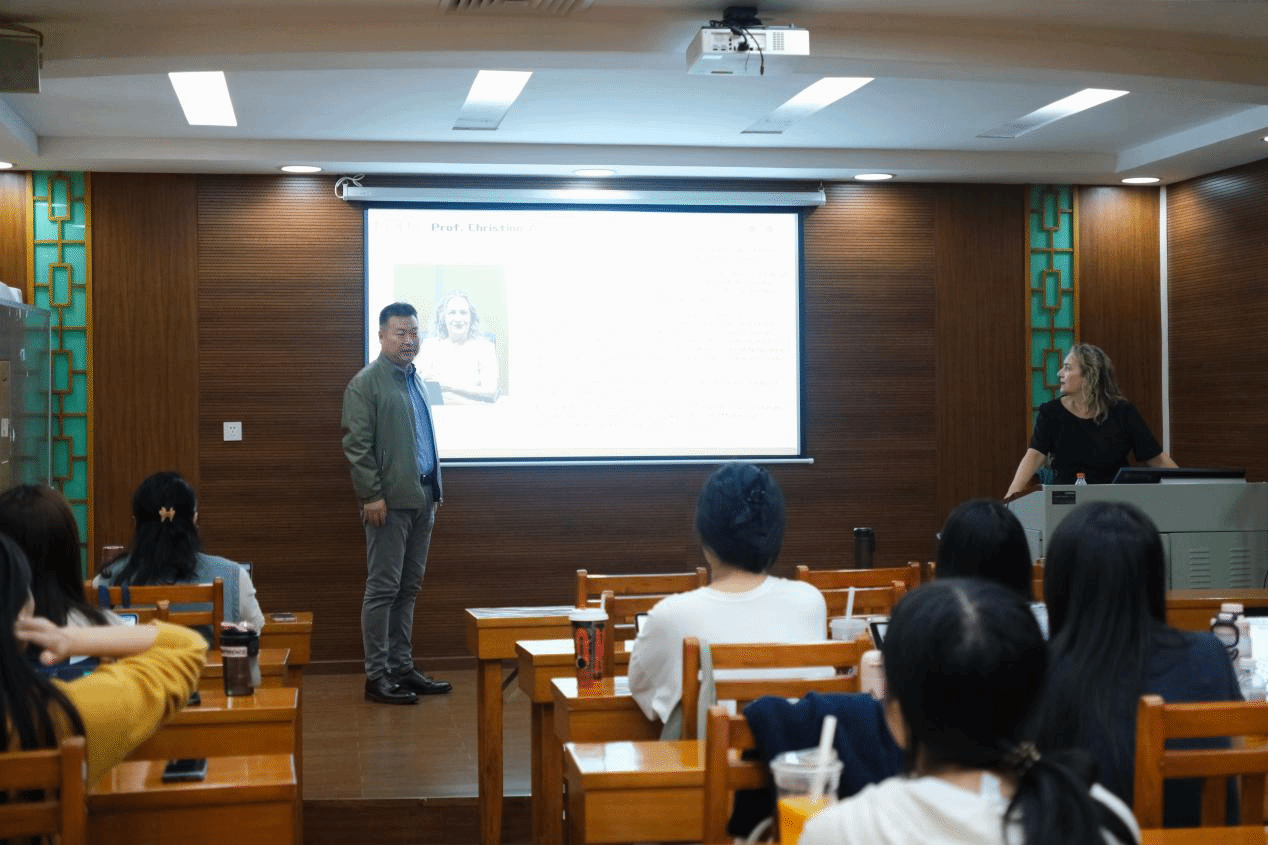
杜家利教授主持讲座
Alexandris教授首先梳理了生成式人工智能在自然语言处理应用中带来的进展与挑战。她指出:系统速度与效率的显著提升,并不意味着语言处理中的复杂问题已经解决。资源较少的语言及其群体代表性不足、表达风格趋同等问题,可能与文本理解障碍、人机交互使用受阻、信息获取困难、出错及形成错误假设的风险、错误发现与纠正困难等问题相联系。
随后,她从文本类型、用户需求及社会与个人福祉出发,重点讨论了资源较少的语言类型,使用经验较少的用户需求,以及因疲劳、年龄或身体状况等因素而面临交互困难的用户特点。她提出:必要时可根据应用类型和用户群体选择进行相应的数据处理,扩大信息与服务的可及性、提升易用性,使更多群体的感受、观点与反应得到更好的反馈。
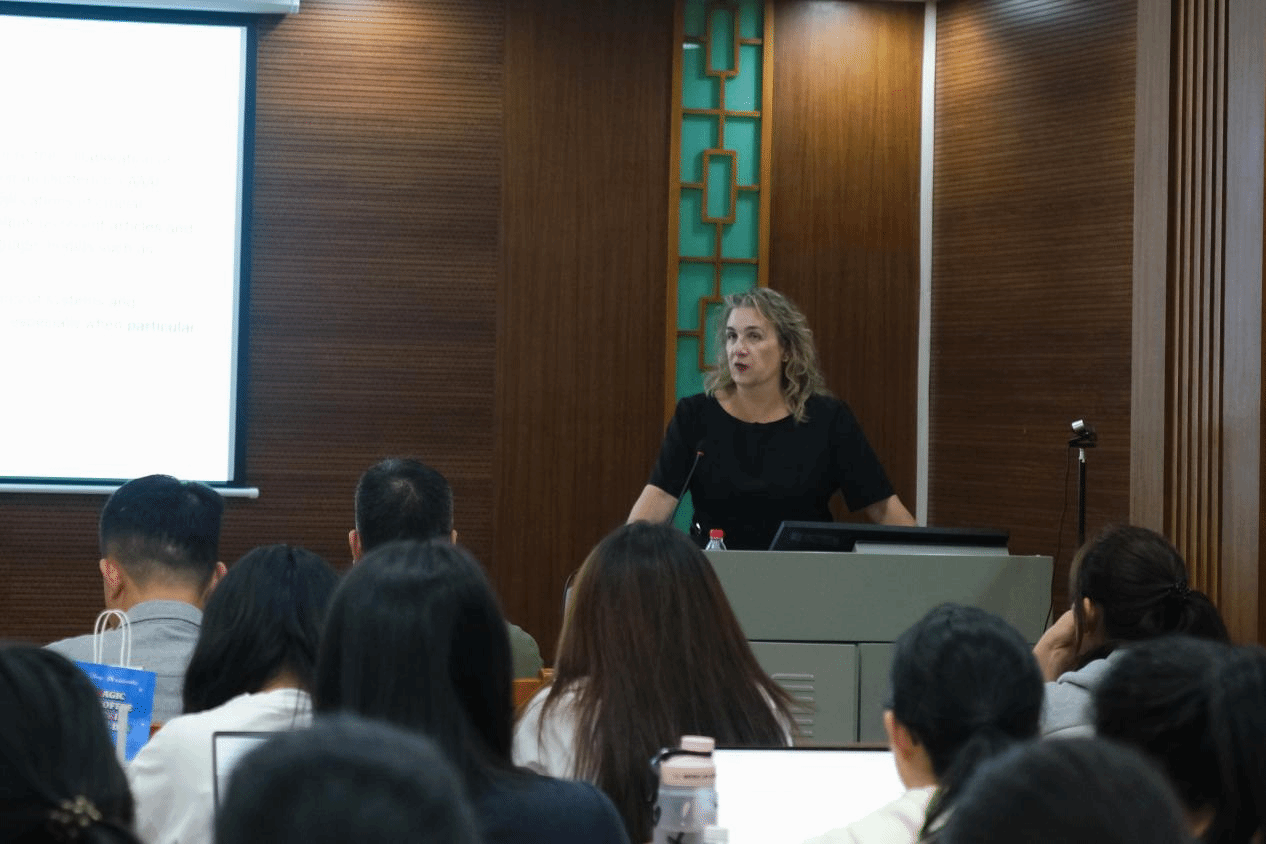
Christina Alexandris教授讲座分享
在此基础上,Alexandris教授介绍了将经典理论、原则和模型融入先进数据驱动方法的混合思路,探讨如何兼顾处理速度、准确性与易用性。她围绕格赖斯合作原则、交际金字塔模型、认知偏差理论框架和普拉切克情绪轮模型,分别讨论其在机器翻译、对话系统、信息抽取及情感分析等应用中的作用。
结合具体案例,她进一步说明了合作原则的各项准则如何有助于实现清晰、准确的表达,交际金字塔模型如何帮助接收者根据其知识水平调整术语与措辞的认知度。她还以修昔底德《伯罗奔尼撒战争史》和孙子的《孙子兵法》的信息抽取研究为例,讨论如何结合认知偏差的特点引导用户检索古代经典中的相关信息,并介绍了如何借助情绪轮模型和知识图谱处理细微情绪及隐含信息。
最后,Alexandris教授指出:相关讨论主要关注数据准备与评价环节。经典理论与现代技术的结合可能有助于丰富训练数据、改进系统输出,但其有效性仍需通过进一步研究、实施与测试加以检验。
本次讲座将语言学理论与人工智能应用相联系,为师生思考技术效率、用户需求与社会责任之间的关系提供了启发。
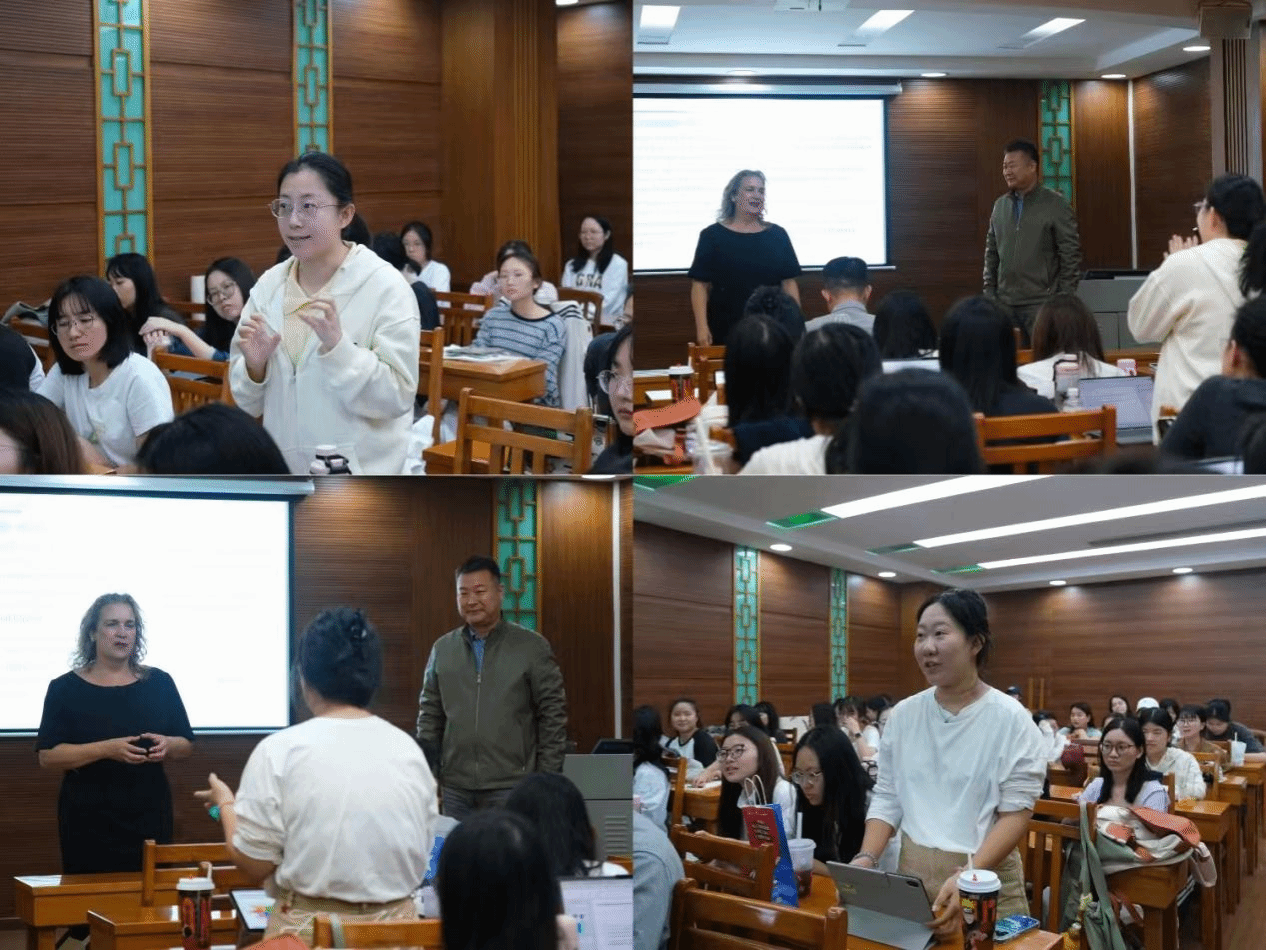
博士研究生提问